




发票OCR识别API接口选型指南:从准确率到合规性的企业级决策框架
一、先厘清需求边界:你的业务到底需要识别什么
选型的第一步不是对比服务商,而是搞清楚自己的业务场景。很多企业在评估阶段就选错了方向,根本原因在于把“票据”和“发票”混为一谈。
“票据”是一个泛称,涵盖增值税发票、火车票、出租车票、机票行程单、银行回单、医疗票据、购物小票等所有可报销或可入账的凭证。而“发票”特指由税务机关监管的税票,主要是增值税系列,字段规范更严格,处理时需要满足税务口径。
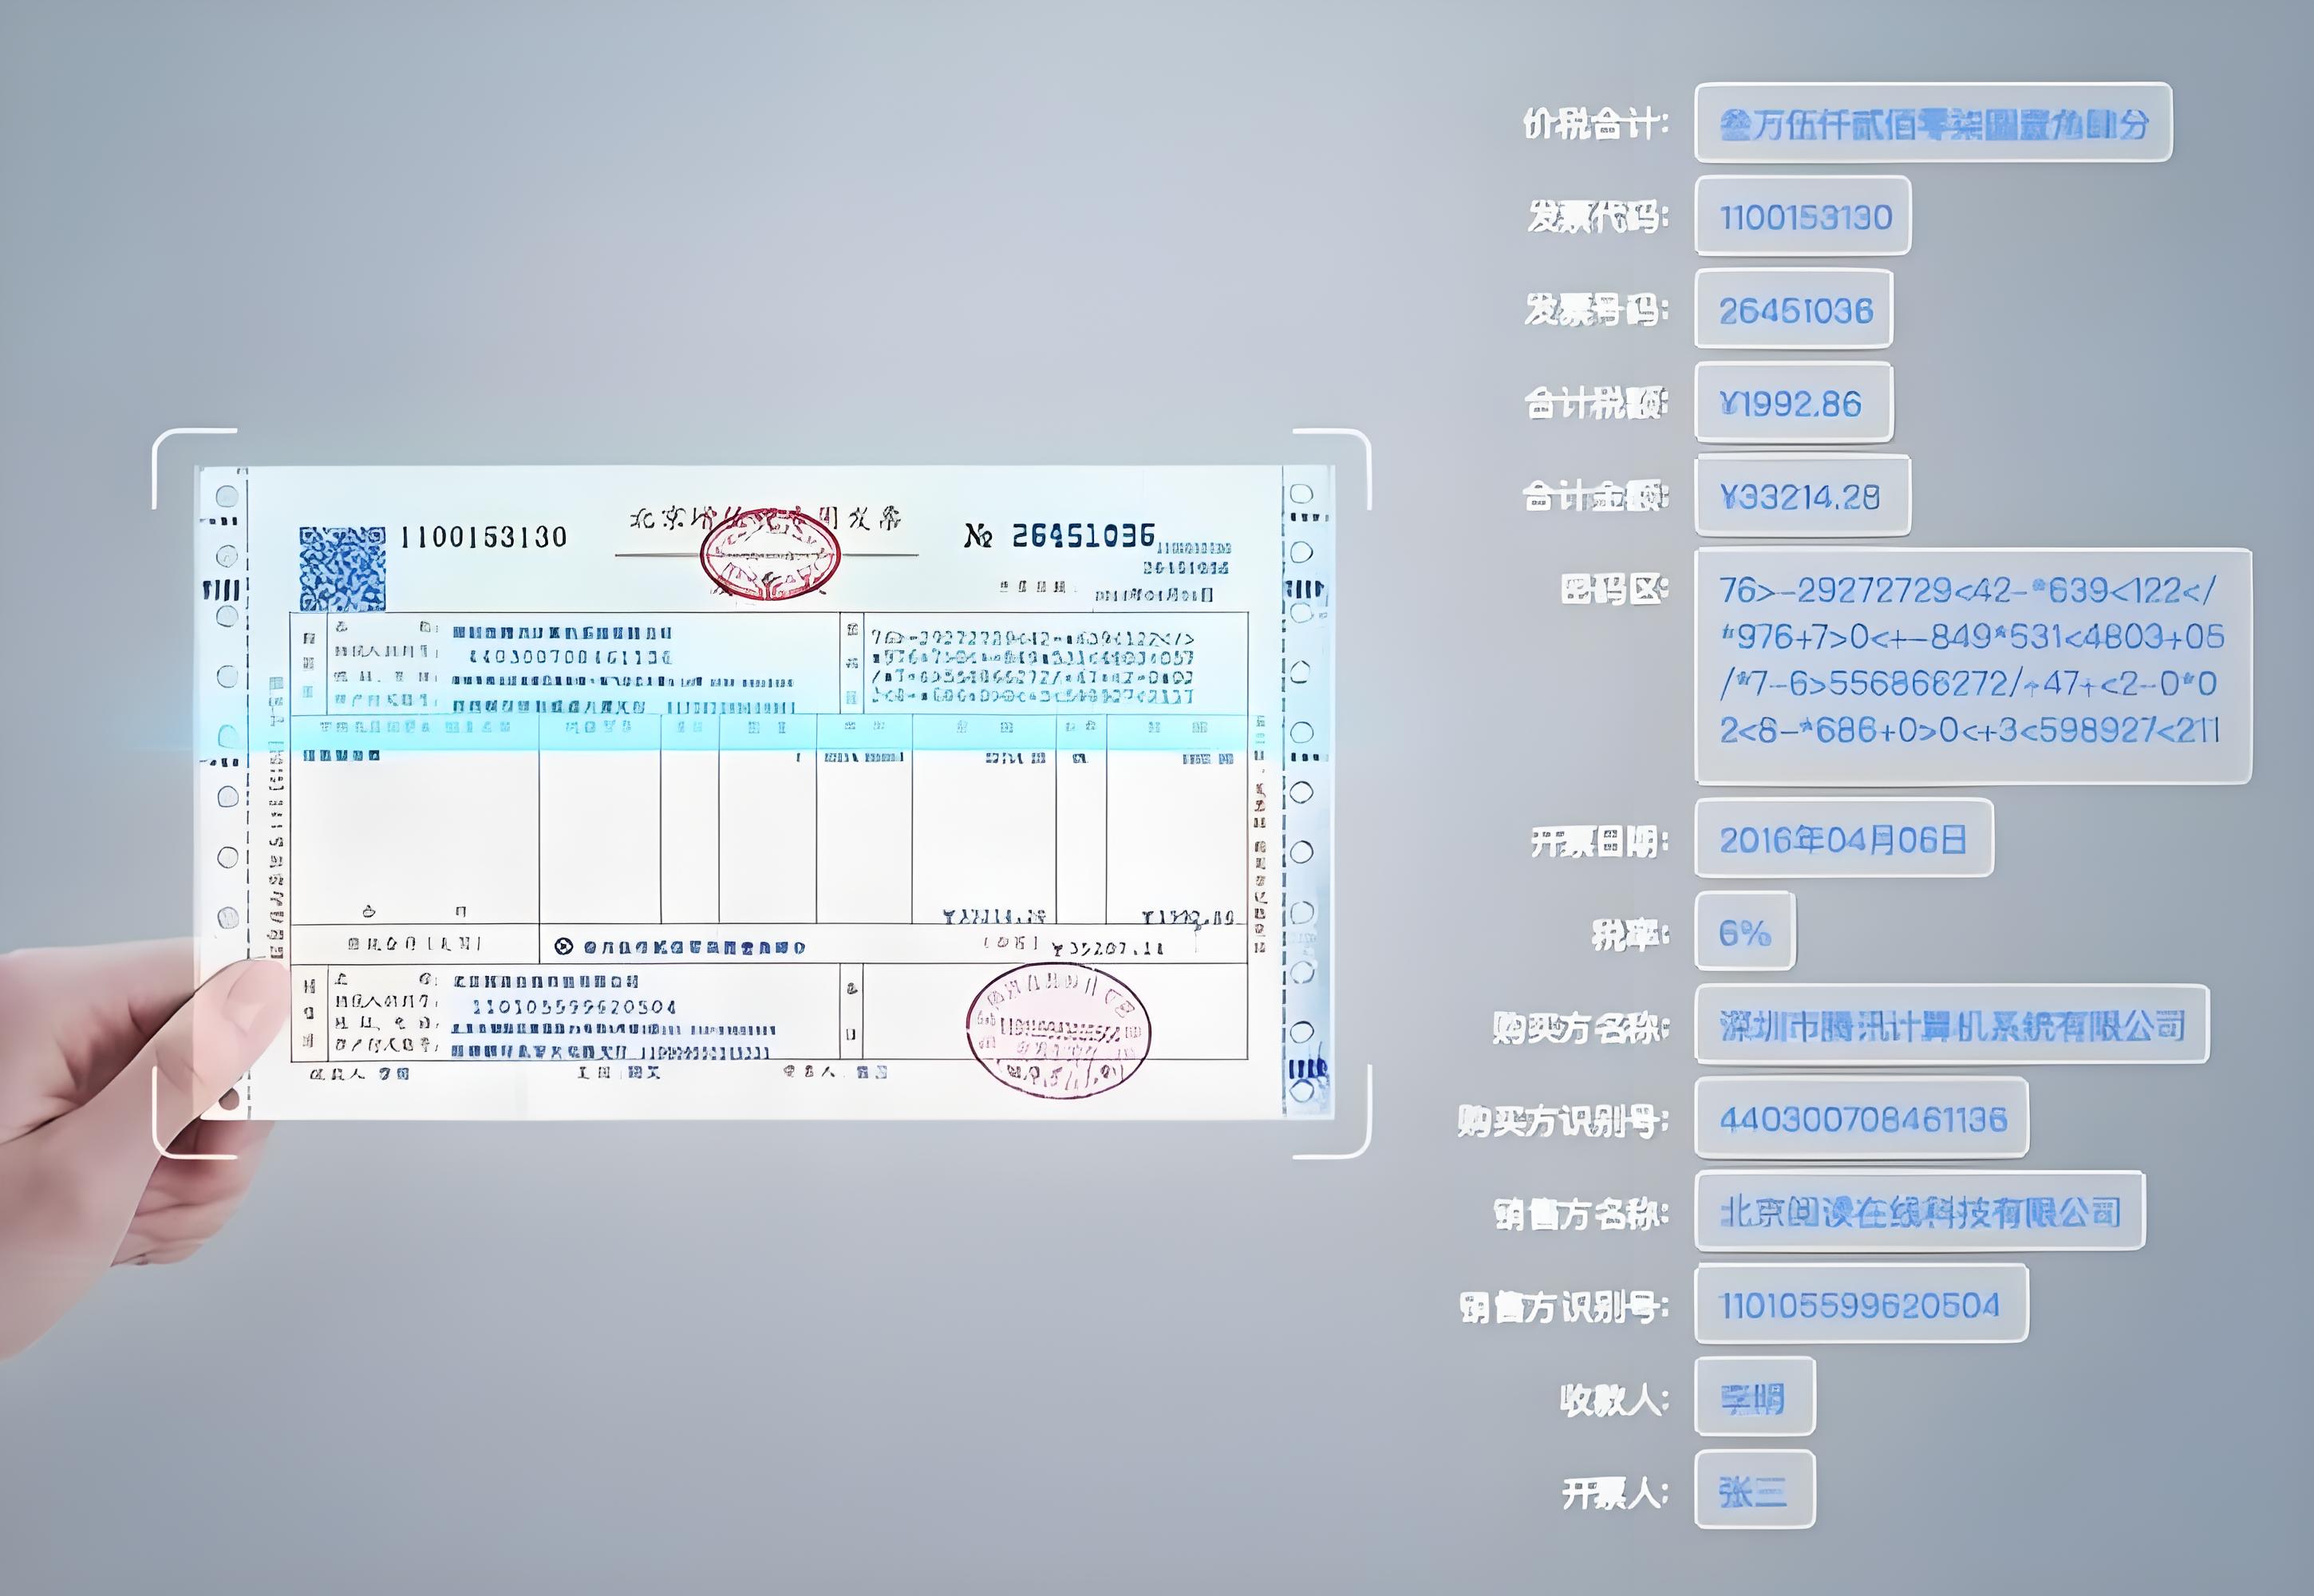
这意味着,如果企业的场景是员工报销——员工把5张不同类型的票据贴在一张A4纸上拍照上传——就需要支持“混贴识别”的通用票据识别接口,而不是单纯的增值税发票识别接口。反过来,如果场景是费控系统入账,需要拿到发票的全部字段用于会计核算,则必须选用字段更完整的增值税发票识别接口。
在需求梳理阶段,建议企业从三个问题入手:第一,需要识别哪些票种? 是仅覆盖增值税专票和普票,还是需要同时处理数电票的OFD格式、机动车销售发票、过路费票据等?第二,输入格式有哪些? 是扫描件、手机拍照、PDF电子发票,还是OFD版式文件?第三,识别结果如何使用? 是简单提取文字供人工确认,还是需要结构化字段直接对接到ERP或费控系统?
明确这三个问题后,选型的方向就会清晰很多。
二、核心评估维度:识别准确率不只是看数字
识别准确率是选型中最常被提及的指标,也是最容易被营销话术模糊的指标。各家服务商动辄宣称“准确率99%以上”,但这个数字背后的含义差异巨大。
准确率需要区分两个层次:字符级准确率和字段级准确率。字符级准确率衡量的是单个字符的识别正确率,而字段级准确率衡量的是完整字段(如发票号码、价税合计)是否全部识别正确。对于财务场景来说,字段级准确率才是真正影响业务的关键指标——一个字符错误可能导致整个金额字段失效。
从第三方评测数据来看,百度智能云OCR在增值税发票场景下的字符准确率为97.8%,字段准确率为95.8%,支持10种发票版式自动分类,预处理算法可修正30%倾斜文档。腾讯云OCR的字符准确率为96.1%,字段准确率为93.2%,在混贴发票场景下总体准确率可达98%。阿里云OCR在复杂表格与票据的版面分析上表现突出,混贴发票总体准确率同样可达98%。
但需要特别注意的是,这些数字是在特定测试集上得出的。实际业务中,发票的质量差异极大——针式打印的发票字迹模糊、油墨污损、折叠痕迹、拍照角度倾斜等问题都会影响识别效果。合合信息的票据识别方案在这一维度表现突出,全票种平均识别率94%以上,增值税发票和电子医疗票据等常见票种准确率高达97%以上,针对针式打印或油墨污损等干扰有专项优化,单张票据识别仅需0.6秒。
在选型评估时,建议企业不要只看服务商提供的基准测试数据,而是用自己的真实发票样本做实测——特别是那些质量较差的样本,因为这些才是区分产品优劣的关键。
三、合规与安全:数电票时代的必答题
发票OCR识别API的选型,正在从纯技术决策变为技术加合规的复合决策。2025年以来,多项政策的密集出台深刻改变了发票管理的合规要求。
财政部等九部门联合发布了《关于推广应用电子凭证会计数据标准的通知》,要求支持电子凭证接收、验签、解析、入账等环节全流程标准化、无纸化处理。接收方单位需要在2027年12月31日之前按照电子凭证会计数据标准对会计信息系统进行适配改造。与此同时,多地已停止开具纸质增值税专用发票,数电票全面主力化。
这些政策变化对发票OCR识别API提出了新的要求。一方面,API必须支持OFD格式的解析能力,因为数电票以OFD和XML为主要载体;另一方面,API需要具备与国家税务机关发票查验平台对接的能力,实现发票真伪核验。
在数据安全层面,电子发票的全生命周期——从采集、传输、存储、使用到销毁——都需要进行个人信息等敏感数据的安全防护。对于金融、政务等对数据安全要求较高的行业,发票OCR识别API是否支持私有化部署、是否通过等保三级认证、是否提供传输加密和审计日志,都应当纳入评估清单。
四、成本与集成:算清总账比看单价更重要
发票OCR识别API的定价模式通常按调用次数计费,但不同服务商的免费额度、阶梯定价和资源包策略差异较大。
从公开信息来看,腾讯云OCR提供每月1000次的免费额度,超出后约0.035元/次;百度OCR提供每天500次的免费额度,超出后约0.04元/次。阿里云的标准接口价格不低,但对于千万级以上的调用量,商务折扣空间和资源包玩法较为丰富。
然而,真正的成本评估不应止步于API调用单价。以下几个隐性成本同样值得关注:
集成开发成本。百度的API文档和SDK封装在开发者社区口碑较好,支持Java、Python、Go等主流语言,开箱即用。腾讯云的示例代码齐全、中文文档详细,但控制台操作相对复杂。阿里云的接口在应对高并发流量时表现稳定,但权限配置和角色管理对个人开发者有一定学习门槛。
运维与调优成本。发票OCR识别API在实际部署中往往需要一定的后处理逻辑,比如字段校验、异常检测和人工复核触发机制。如果服务商提供了智能纠错和逻辑校验能力(如金额一致性检查、税号合法性验证),可以显著降低后处理开发量。
扩展成本。随着业务增长,企业可能需要从单一票种识别扩展到多票种混贴识别,从公有云API扩展到私有化部署。如果初期选型的服务商不支持这些扩展路径,后期迁移的成本可能远超API调用费用本身。
五、技术趋势前瞻:大模型正在重塑发票识别
在选型时,企业还需要关注一个正在发生的技术变革:大模型与OCR的融合正在重新定义发票识别API的能力边界。
传统的发票OCR识别API本质上是一个“感知层”工具——它能认出图中的文字,但不理解文字背后的语义关系。而大模型驱动的方案,正在让发票识别从“感知”走向“认知”。2026年,基于大语言模型的视觉命名实体识别技术,能够在发票图像上实现更高的上下文敏感性和准确率,远超传统方法。混合架构——将OCR与大语言模型结合——已成为行业最佳实践,能够在最大化可扩展性的同时最小化人工干预。
在实际产品层面,DeepSeek-OCR2等新一代模型引入了“视觉因果流”概念,能够根据图像语义动态调整视觉信息的处理顺序,不再机械地按从左到右扫描,而是根据内容密度智能排序。这种能力对于处理扭曲的发票、密集的小字财报等传统OCR的“死穴”场景具有重要意义。
对于企业选型而言,这意味着两件事:第一,在评估服务商时,应当关注其是否已在大模型方向有明确的技术路线和产品落地,而非仅看当前的识别准确率。第二,大模型方案的定价逻辑可能与传统OCR API完全不同——DeepSeek-OCR2的发布已经引发了OCR市场价格体系的震动,企业原有的“按调用次数计费”的成本模型可能需要重新审视。
六、分场景选型建议
综合以上分析,不同类型的企业在发票OCR识别API选型时可以参照以下思路:
中小企业与初创团队,优先考虑接入门槛低、免费额度充足的服务。百度智能云OCR的文档友好度最高,适合快速验证和原型开发;腾讯云OCR的发票场景优化较好,免费额度按天计算,适合少量多次的调用模式。
中大型企业的财务共享中心,需要重点评估字段级准确率、多票种混贴识别能力和合规对接能力。阿里云OCR在复杂表格和财务供应链场景的优势明显,腾讯云OCR的通用票据识别支持14大类标准报销发票的混贴识别,适合处理员工报销场景中票种混杂的情况。
金融、政务等高安全要求行业,应将私有化部署能力和数据安全认证作为一票否决项。合合信息等专业OCR厂商提供公有云API、私有化部署和混合云架构的灵活选择,支持“线上验证,线下部署”的无缝衔接。
结语
发票OCR识别API的选型,本质上是一次“匹配”而非“比较”——没有绝对最好的服务商,只有最适合业务场景的方案。在数电票全面普及和财务数字化加速的当下,建议企业将选型视为一个动态过程:先明确业务边界,再以识别精度和合规安全为硬指标,以成本和集成效率为软约束,同时为大模型时代的范式迁移预留足够的弹性。
毕竟,好的发票OCR识别API不是让财务系统“能认字”,而是让发票数据在企业的业务流中真正流动起来——从识别到验真,从入账到归档,每一个环节都无缝衔接。这才是技术选型最终要回答的问题。
 相关资讯
2024-02-29
2021-11-25

2021-06-16
2025-03-18
2025-09-10

2022-11-10
2025-11-24
2026-06-01
2025-07-01
2026-09-09

全天候售后服务
7x24小时专业工程师品质服务

极速响应贴身服务
快速应答解决业务问题

客户至上价值
客户优先,创造客户价值

全方位安全保障
打造安全可信的平台
 让数据流通 赋能商业价值
 客服微信
 官方公众号
